
heitorrosa/cvm-corpus
CVM Filings Corpus (PT-BR) Brazilian CVM regulatory filings in Portuguese, cleaned and chunked for language-model pretraining. Built for DAPT on financial Portuguese. Contents Path What output/corpus.jsonl Full corpus (7.2 GB). Chunk schema: text, company, cnpj, category, subject, date, year, document_id, chunk_id, extraction_quality. output/corpus-250M.jsonl DSIR-selected 250M-token subset (token count by chars÷4 proxy ≈ 150M whitespace tokens): 187… See the full description on the dataset page: https://huggingface.co/datasets/heitorrosa/cvm-corpus.
CVM Filings Corpus (PT-BR)
Brazilian CVM regulatory filings in Portuguese, cleaned and chunked for language-model pretraining. Built for DAPT on financial Portuguese.
Contents
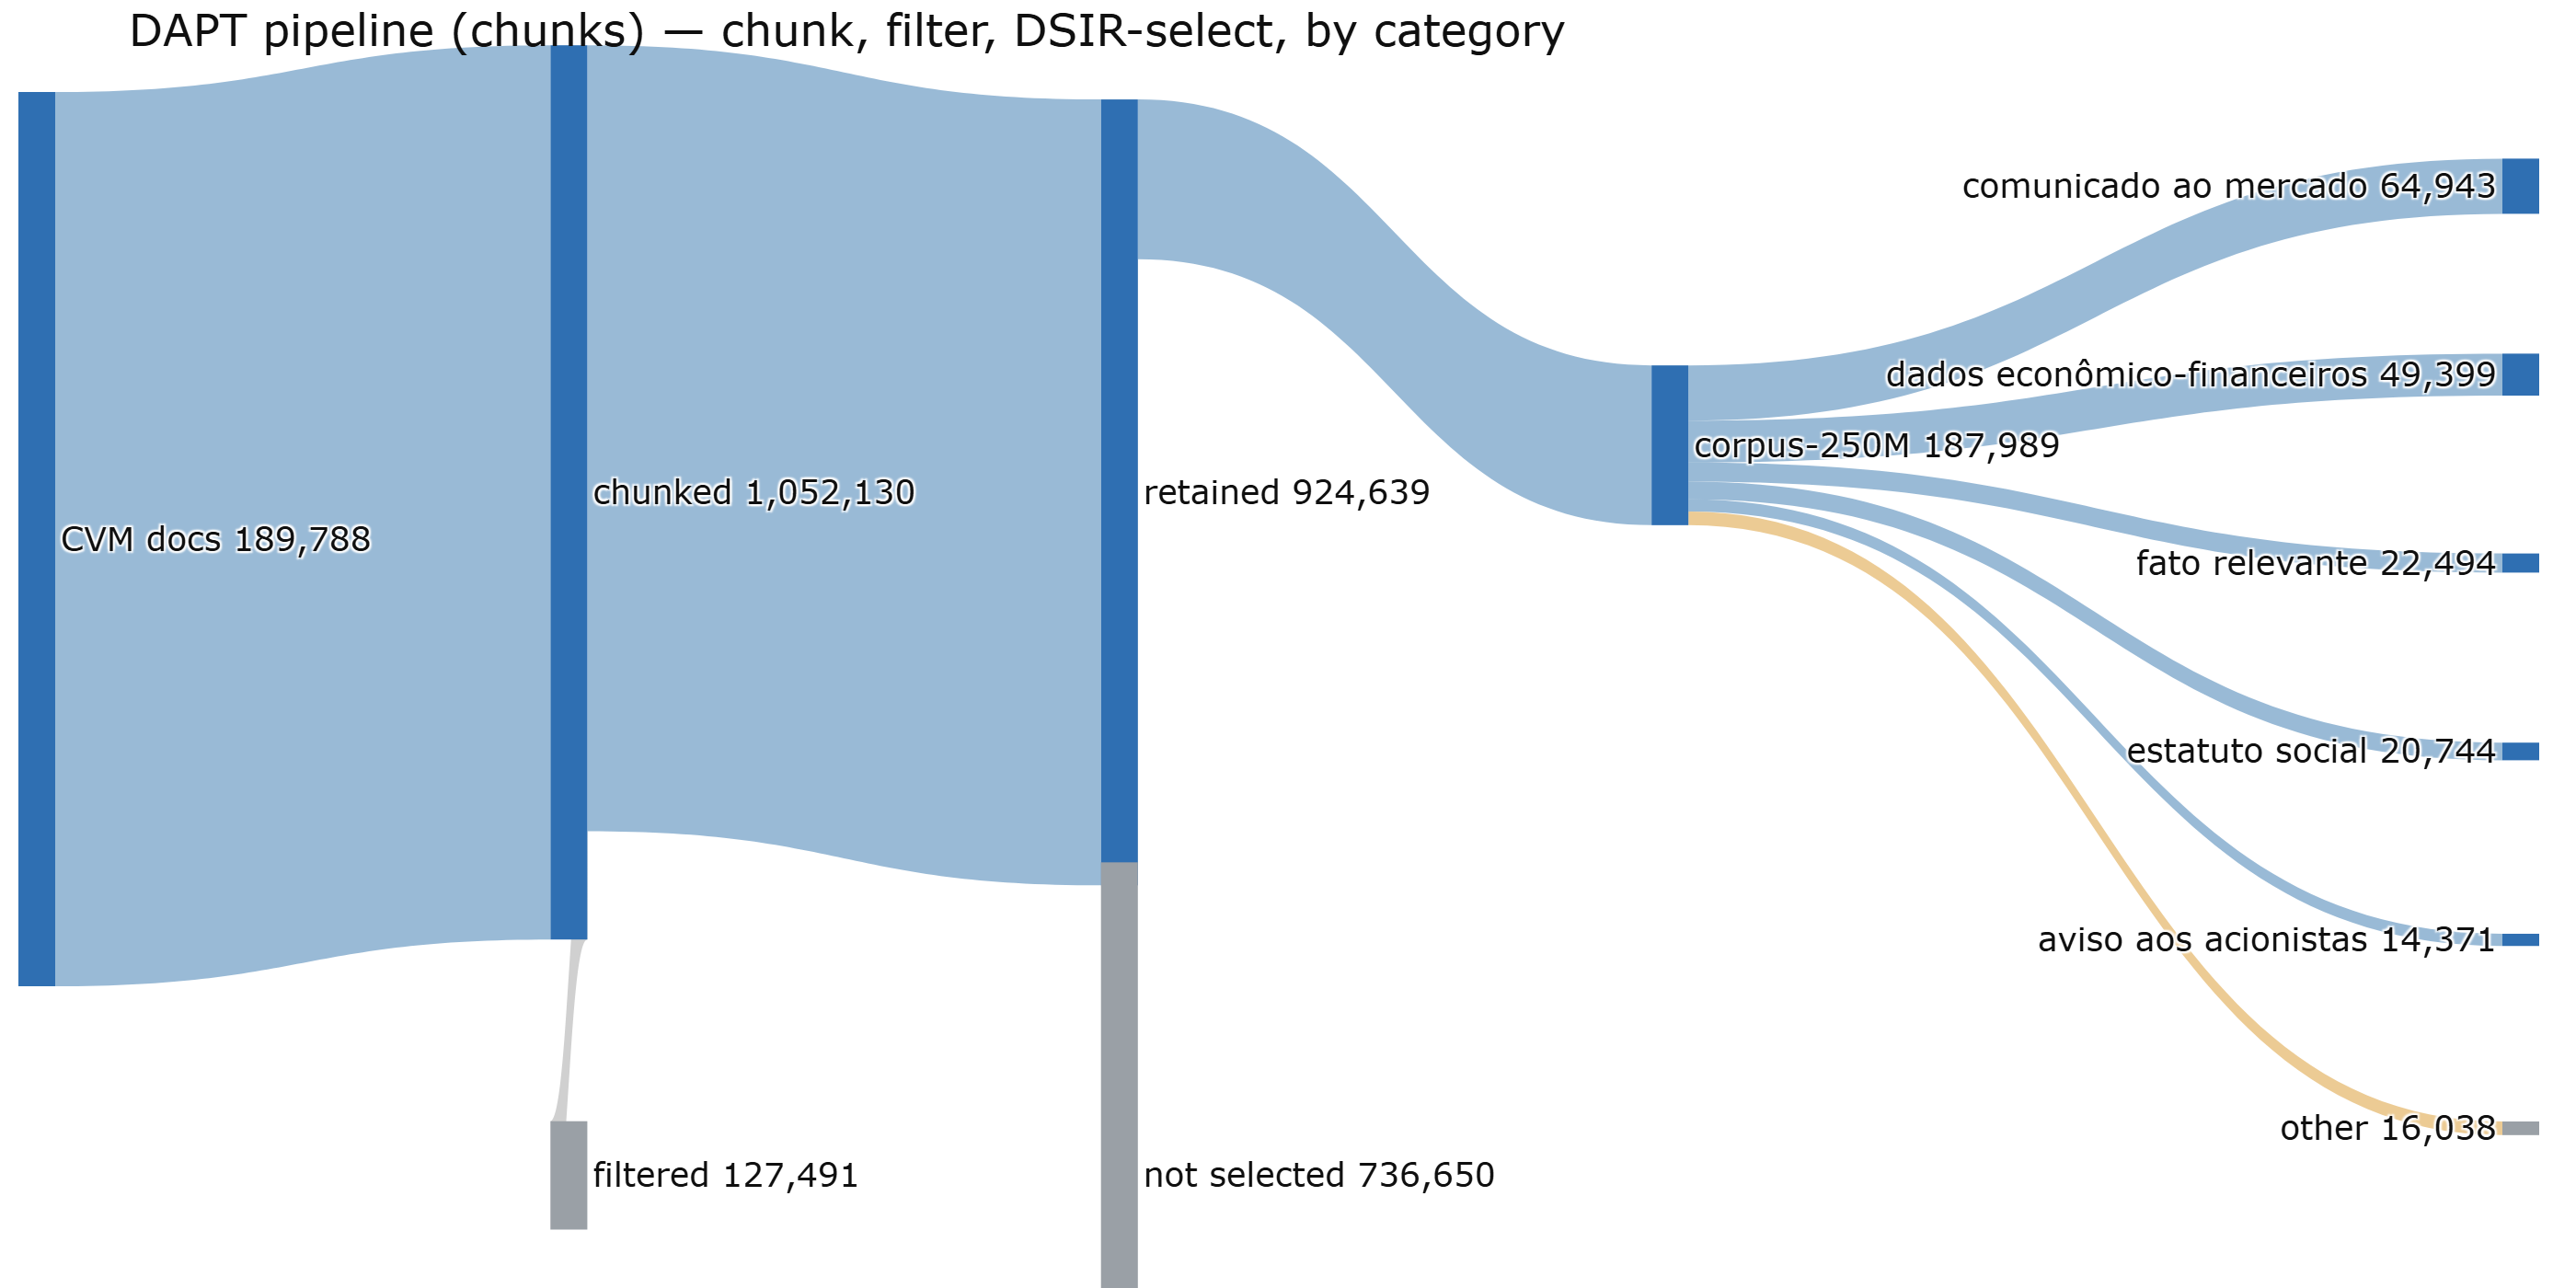
Pipeline
Scrape (CVM ENET) -> merge -> clean -> DSIR-select against an INPE-style target distribution.
Exact code at: https://github.com/mansa-team/musa
Data quality
Measured on the 250M subset: residual junk 3.7%, exact-duplicate 0.4%, median chunk 943 whitespace tokens.
TODO
- [ ] Add 2021–2026 filings and a final merge
Cite
@misc{heitor_de_oliveira_rosa_2026,
	author       = { Heitor de Oliveira Rosa },
	title        = { cvm-corpus (Revision bf07404) },
	year         = 2026,
	url          = { https://huggingface.co/datasets/heitorrosa/cvm-corpus },
	doi          = { 10.57967/hf/10644 },
	publisher    = { Hugging Face }
}